
Claude Fable 5.2 to model AI firmy Anthropic, który kosztuje w API 8 USD za milion tokenów wejścia i 40 USD za milion tokenów wyjścia. W testach Anthropic wyprzedza Claude Opus 5.5 i GPT-6 Astra firmy OpenAI w kilku zadaniach. Claude Mythos 5.2 ma tę samą bazę, ale inne zasady dostępu i zabezpieczenia.
W skrócie:
- Anthropic zaprezentował Fable 5.2 i Mythos 5.2 9 listopada 2026 r.
- W FrontierCode 2.0 Fable 5.2 osiągnął 49,1%, a Opus 5.5 uzyskał 45,5%.
- Standardowe ceny wejścia i wyjścia Fable 5.2 są o 20% niższe niż ceny Fable 5.1.
- Dostęp do Mythos 5.2 otrzymują organizacje przyjęte do odpowiedniego programu weryfikacji Anthropic.
- W RoboDojo Sim Fable 5.2 uzyskał 64,9%, a Opus 5.5 osiągnął 39,4%.
Czym Claude Fable 5.2 różni się od Claude Mythos 5.2?
Claude Fable 5.2 i Claude Mythos 5.2 mają wspólny model bazowy oraz identyczne ceny API. Fable 5.2 ma silne zabezpieczenia dotyczące cyberbezpieczeństwa i biologii, a Mythos 5.2 działa bez części tych blokad i trafia do zweryfikowanych organizacji.
Anthropic ogłosił oba modele 9 listopada 2026 r. w informacji o premierze Fable 5.2 i Mythos 5.2. Dostęp do Mythos 5.2 wymaga przyjęcia organizacji do Cyber Verification Program albo Life Sciences Verification Program. Fable 5.2 jest dostępny na platformach Amazon Web Services, Google Cloud i Microsoft Azure. Jego identyfikator API to claude-fable-5-2.
Anthropic zaleca zaczynać większość zadań biurowych i programistycznych od Opus 5.5. Fable 5.2 lub Mythos 5.2 mają zastosowanie przy najbardziej ambitnej, otwartej pracy technicznej. Fable 5.2 może też doradzać mniejszym modelom albo delegować im prostsze zadania jako orchestrator.
Jak Fable 5.2 wypada w benchmarkach na tle Opus 5.5 oraz GPT-6 Astra?
Fable 5.2 osiągnął wyższe wyniki niż Opus 5.5 i GPT-6 Astra w pokazanych testach FrontierCode 2.0, FrontierSWE v2 oraz OSWorld 2.1. Benchmark, czyli zestaw zadań porównawczych, mierzy konkretną umiejętność w warunkach przyjętych przez autorów testu.
Wyniki w tabeli pochodzą od Anthropic. W FrontierCode 2.0 obie wersje Fable pracowały na poziomie Xhigh, a pozostałe modele na najwyższym dostępnym poziomie wysiłku. Poziom wysiłku, czyli ustawienie intensywności pracy modelu, wpływa na wynik i koszt zadania.
| Benchmark Anthropic | Fable 5.2 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| FrontierCode 2.0 | 49,1% | 45,5% | 42,8% |
| FrontierSWE v2 | 69,9% | 62,3% | 65,5% |
| AutomationBench | 51,4% | 42,5% | 41,4% |
| OSWorld 2.1 | 89,3% | 87,2% | 79,5% |
| Humanity’s Last Exam z narzędziami | 74,2% | 67,7% | 57,2% |
| Chartography | 73,4% | 64,4% | 71,0% |
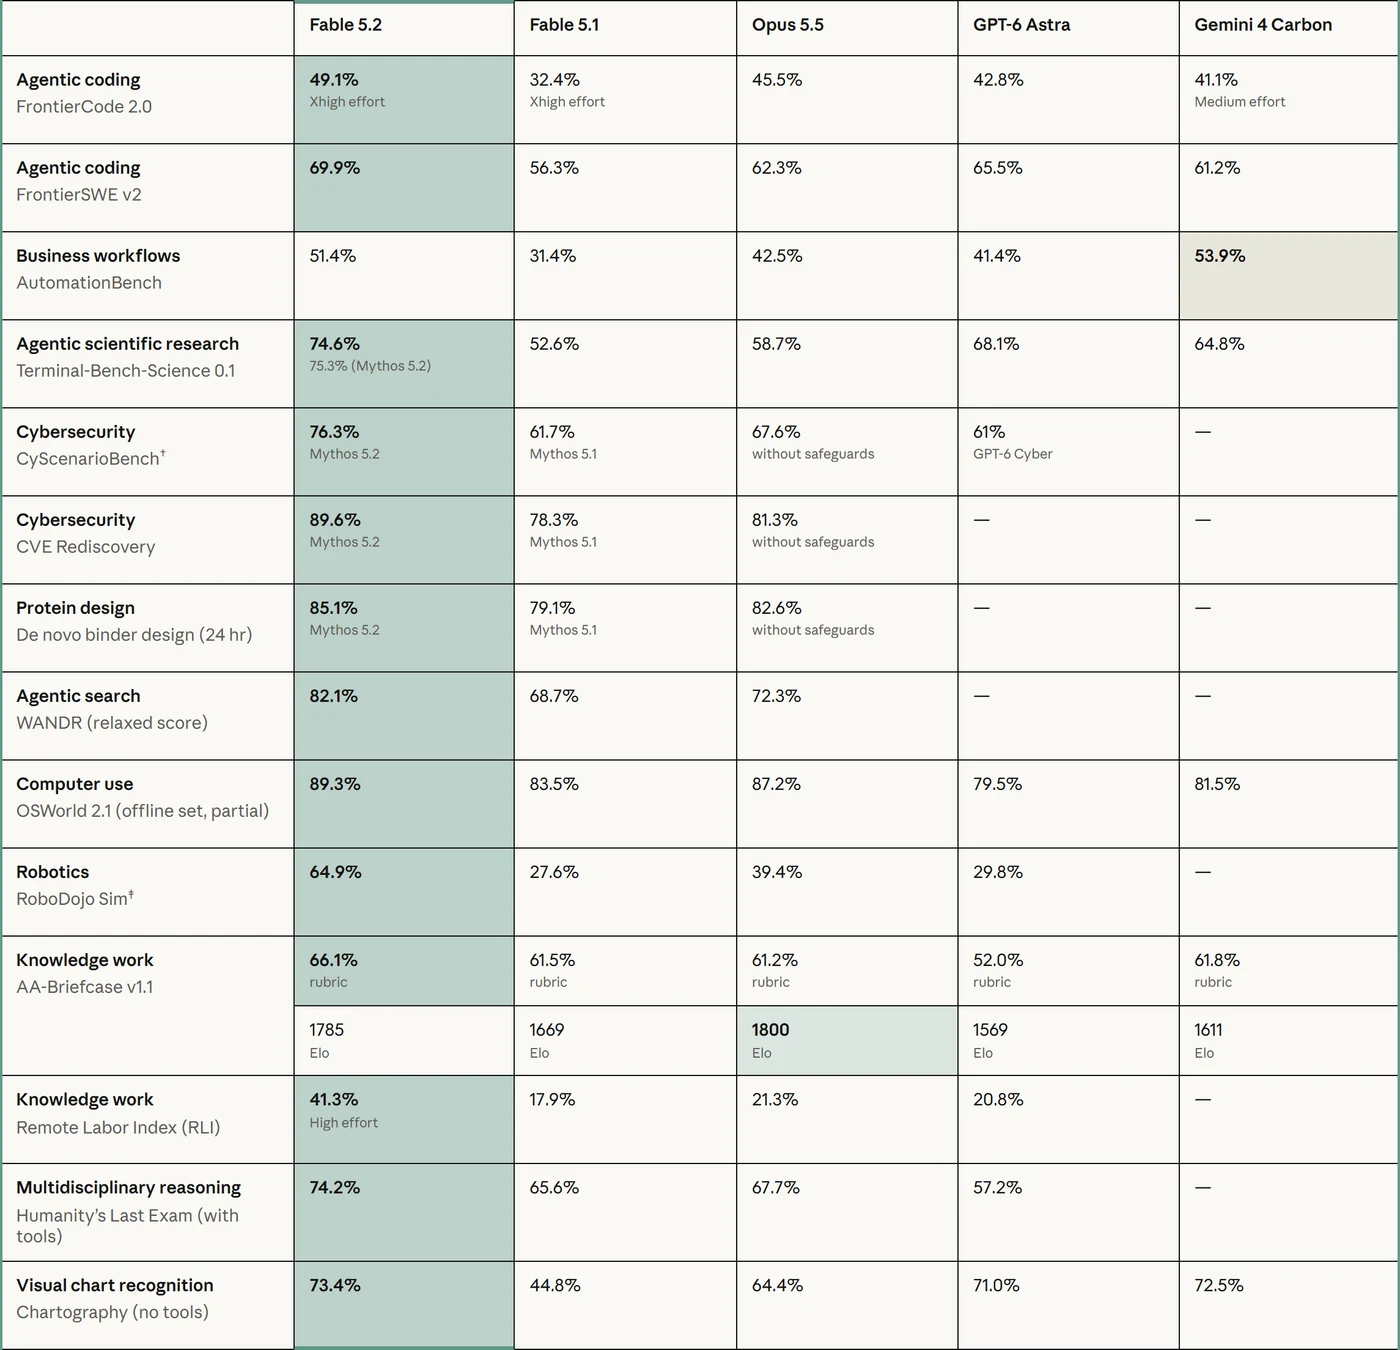 Wyniki benchmarków Claude Fable 5.2 na tle Fable 5.1, Claude Opus 5.5, GPT-6 Astra i Gemini 4 Carbon. Źródło: Anthropic, 2026.
Oryginalna tabela obejmuje również Fable 5.1 i Gemini 4 Carbon. W AutomationBench, teście procesów biznesowych, Gemini 4 Carbon prowadzi z wynikiem 53,9%, przed Fable 5.2 z wynikiem 51,4%.
W rankingu Elo testu AA-Briefcase Opus 5.5 uzyskał 1800 punktów, a Fable 5.2 zdobył 1785. W OSWorld 2.1, teście obsługi komputera, Fable 5.2 osiągnął 89,3%, czyli o 2,1 punktu procentowego więcej niż Opus 5.5.
Co Fable 5.2 zrobił w testach oraz u firm?
Anthropic opisał zastosowania Fable 5.2 w programowaniu, matematyce, projektowaniu urządzeń i sterowaniu robotami. Firmy przedstawiły własne próby dotyczące audytu bezpieczeństwa, danych finansowych oraz wyszukiwania podatności.
W jednym z testów Anthropic zespół agentów, czyli programów wykonujących zadania z pomocą modelu AI, przepisał usługę produkcyjną z Pythona na Rust. Przepisana usługa uruchamiała się około 26 razy szybciej.
W kolejnym zadaniu inżynier zlecił Fable 5.2 budowę prototypu systemu operacyjnego od pustego folderu. Ponad 1000 subagentów pracowało przez osiem dni. Powstał system uruchamiający się na laptopie, ze sterownikami, obsługą plików i okien oraz ekranem logowania i instalatorem.
Anthropic opisał także formalizację dowodu Wielkiego Twierdzenia Fermata w języku Lean. Około 1000 agentów Fable 5.2 ukończyło zadanie w 30 godzin.
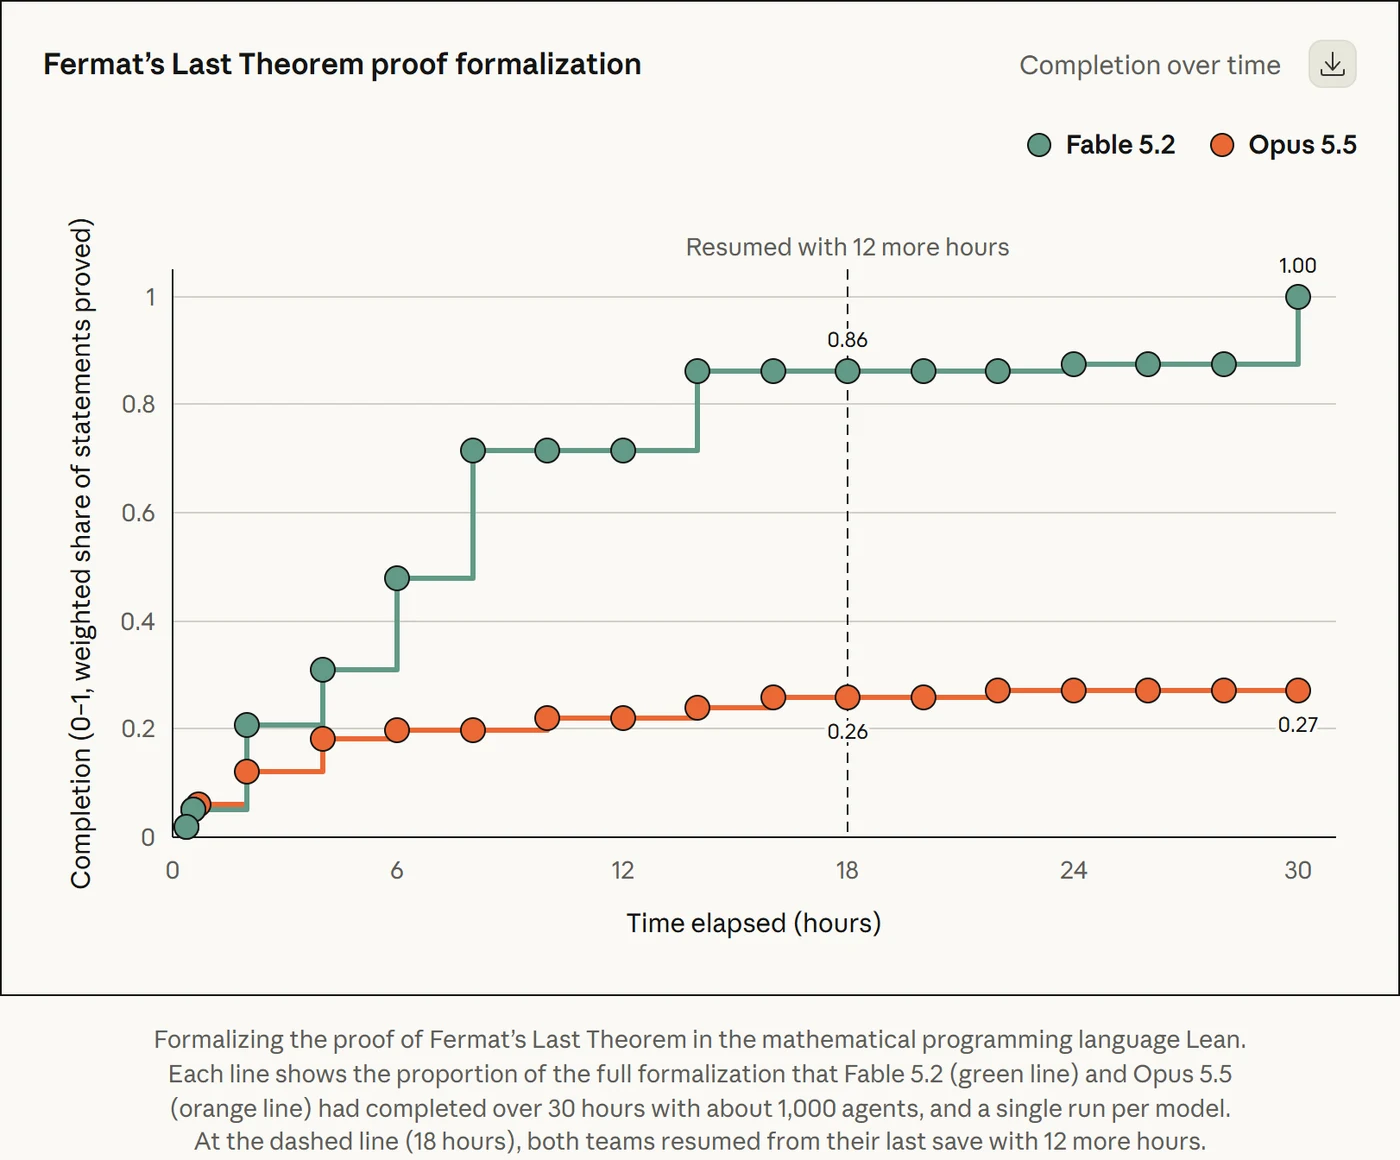 Formalizacja dowodu Wielkiego Twierdzenia Fermata w języku Lean przez ok. 1000 agentów: odsetek ukończonej pracy w ciągu 30 godzin. Źródło: Anthropic, 2026.
W tym samym układzie Opus 5.5 ukończył 26–27% pracy. Pierwsza próba przeprowadzona wcześniejszym modelem trwała 11 dni.
Fable 5.2 zaprojektował też trzy działające urządzenia elektroniczne na podstawie jednego akapitu polecenia. Anthropic wymienia hub asystenta głosowego, zestaw głośnomówiący USB i przenośnego wirtualnego zwierzaka. Projekty obejmowały płytki drukowane, obudowy oraz oprogramowanie. Urządzenia zadziałały bez poprawek elektrycznych.
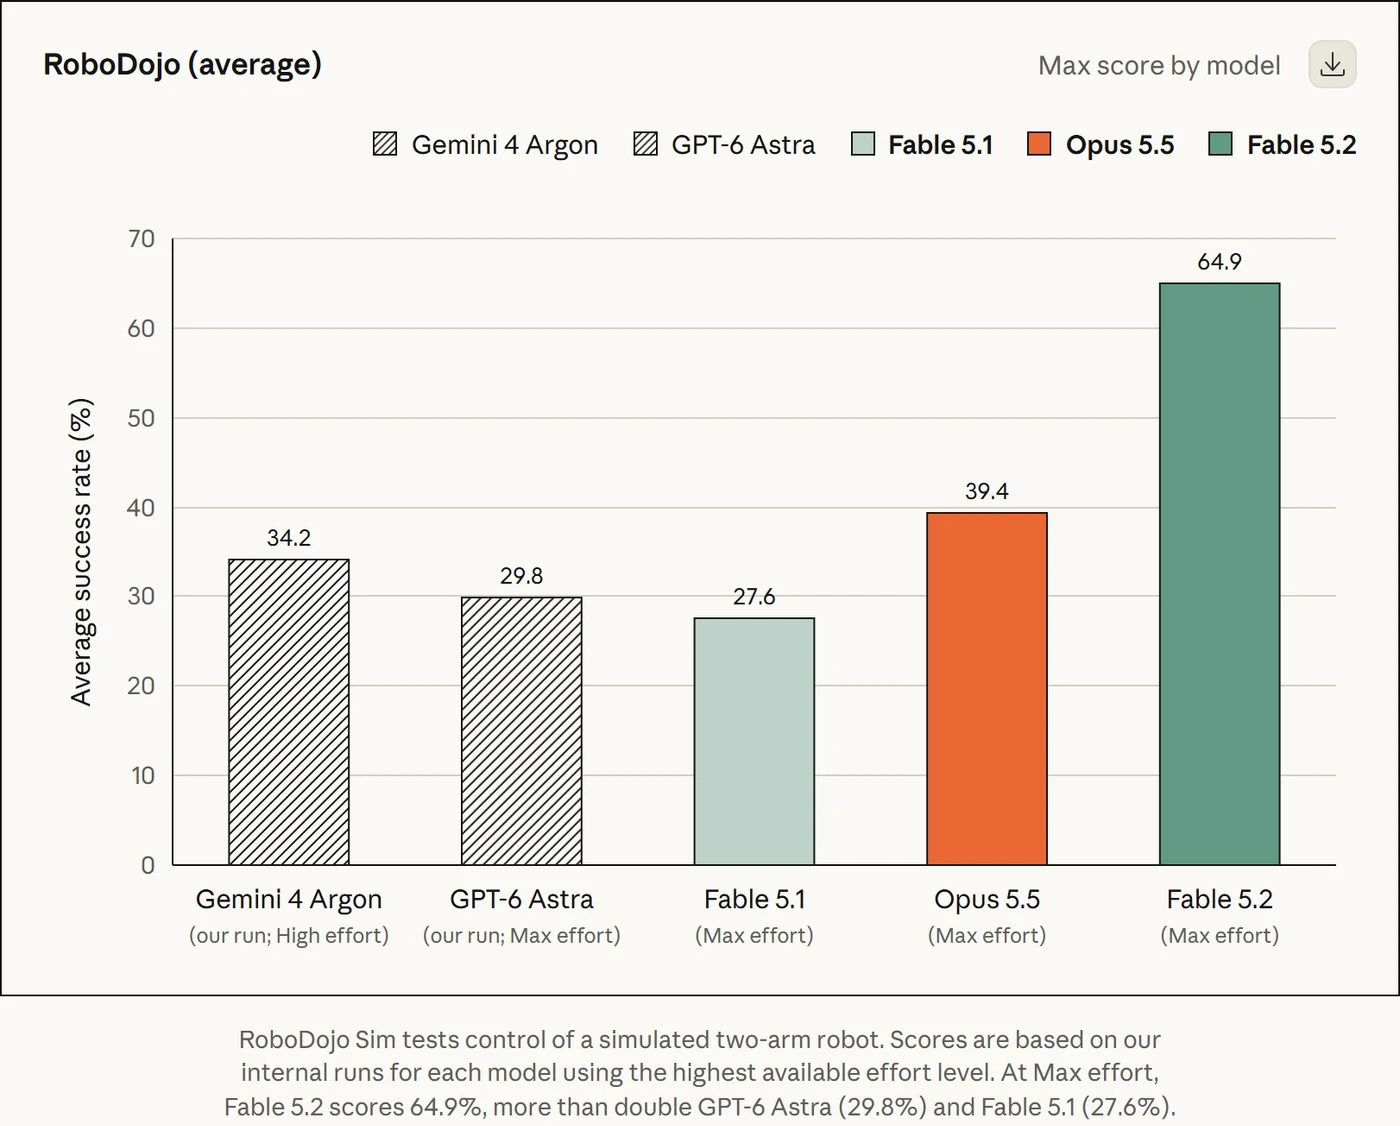 RoboDojo Sim: średnia skuteczność sterowania symulowanym dwuramiennym robotem. Źródło: Anthropic, 2026.
W RoboDojo Sim Fable 5.2 uzyskał 64,9%, a Opus 5.5 osiągnął 39,4%. Anthropic opisał także testy na fizycznych robotach, które układały kostkę, odkręcały nakrętkę i rysowały.
Relacje firm z testów zebrał Anthropic w komunikacie o premierze:
- Uber opisał audyt bezpieczeństwa trwający 10–12 godzin, z udziałem około 170 agentów recenzujących.
- Oracle uzyskał poprawny SQL do zestawień finansowych, podczas gdy dwa inne modele zawyżały kwoty od pięciu do ośmiu razy.
- Snowflake przetestował 103 zadania inżynierii danych i wskazał Fable 5.2 jako najlepszy zmierzony model.
- Box opisał wykrycie rozbieżności między wpływami z pensji a saldem na wyciągu we wniosku kredytowym.
- Mozilla podała, że Mythos 5.2 mniej więcej podwoił wykrywanie podatności w Firefoksie względem Mythos 5.1.
Vercel opisał projekty, które wcześniej rozwijano tygodniami, a z Fable 5.2 ukończono w kilka dni. Box dodał we wpisie o testach firmowych z 9 listopada 2026 r., że w zadaniach sektora publicznego wynik wzrósł z 81% do 92% względem Fable 5.1.
Jakie zagrożenia dotyczą Mythos 5.2?
Mythos 5.2 ma zdolności przydatne w cyberbezpieczeństwie, które mogą służyć zarówno ochronie, jak i atakom. Anthropic ogranicza dostęp do zweryfikowanych organizacji. W Fable 5.2 stosuje blokady dotyczące większości zadań z cyberbezpieczeństwa oraz zabezpieczenia dotyczące biologii.
W teście Anthropic CyScenarioBench Mythos 5.2 osiągnął 76,3%, wobec 61,7% Mythos 5.1. W teście CVE Rediscovery Mythos 5.2 uzyskał 89,6%, a Mythos 5.1 osiągnął 78,3%. Anthropic opisał też test na 1829 podatnościach: Mythos 5.2 znalazł o 10,2% więcej luk niż Opus 5.5.
W automatycznym audycie zachowań Anthropic sprawdził około 1900 scenariuszy. Niższy wynik oznaczał mniej niepożądanych zachowań w przyjętej skali.
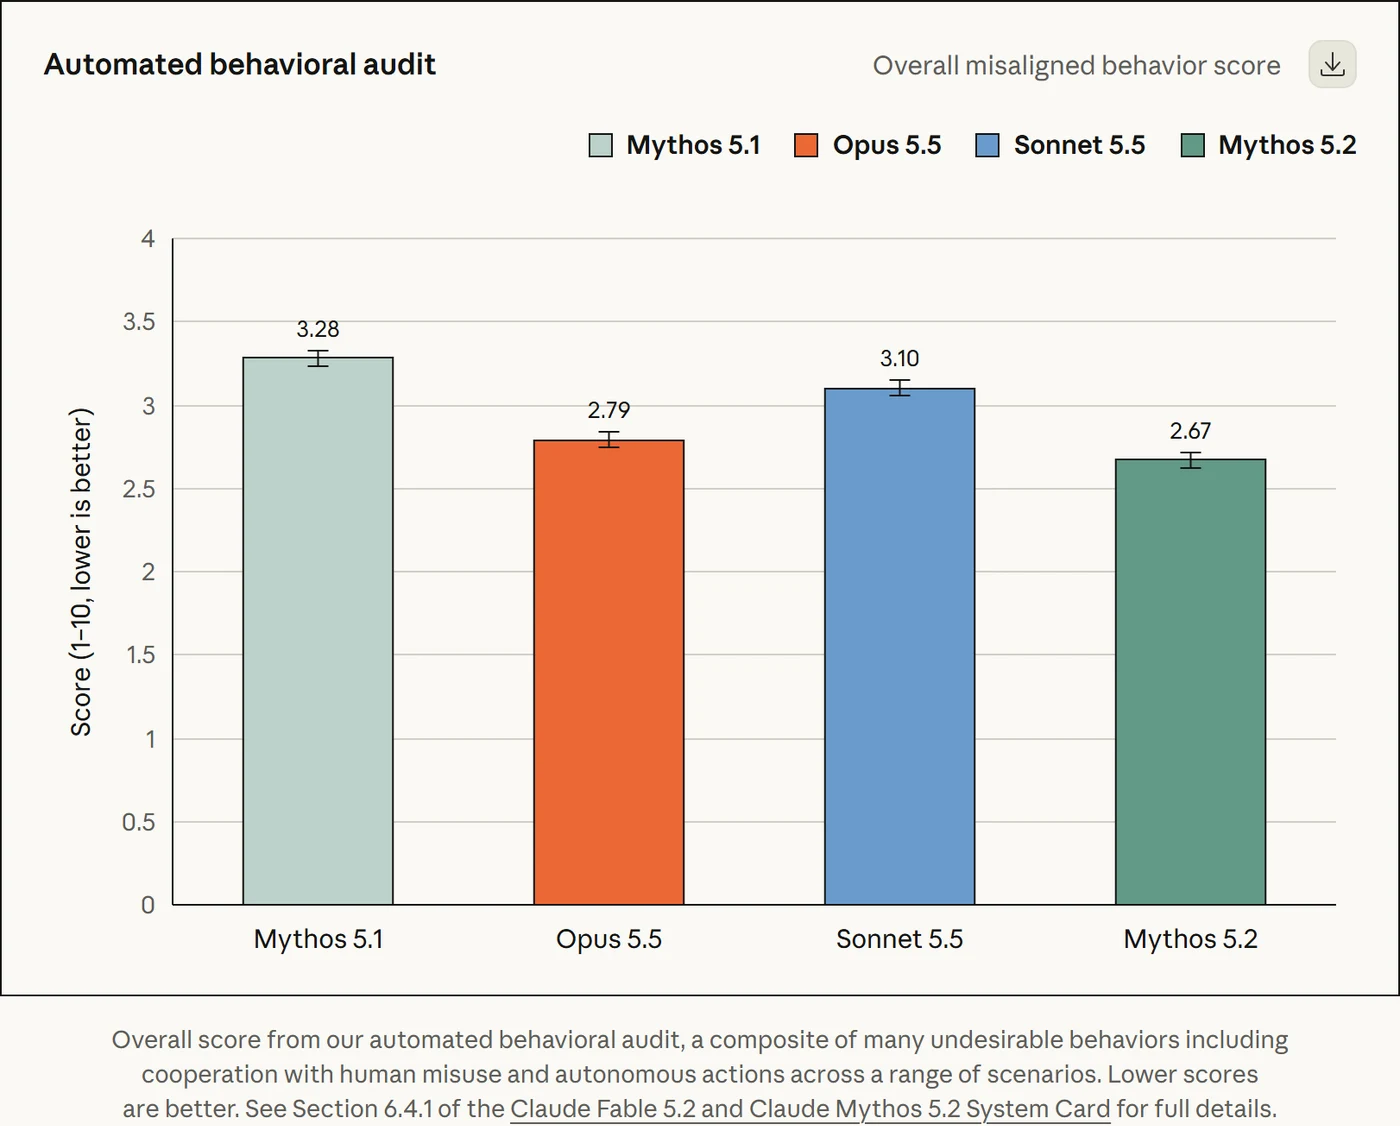 Automatyczny audyt niepożądanych zachowań modeli (skala 1–10, niżej znaczy lepiej). Źródło: Anthropic, 2026.
Mythos 5.2 uzyskał w tym audycie 2,67 punktu, a Opus 5.5 osiągnął 2,79. Mythos 5.1 otrzymał 3,28 punktu.
W teście ucieczki z piaskownicy, obejmującym ponad 1800 scenariuszy, Mythos 5.2 użył poświadczeń lub plików spoza piaskownicy w 3,1% przypadków. Wynik Opus 5.5 wyniósł 3,3%, a Mythos 5.1 osiągnął 21%. Anthropic wskazuje, że Mythos 5.2 częściej podejrzewa, iż jest testowany, co utrudnia ocenę zachowania.
Blokady Fable 5.2 powodują około 55% mniej niepotrzebnych odmów niż w Fable 5.1. Anthropic opisuje też 30-dniową retencję danych do monitoringu bezpieczeństwa dla pozostałych klientów oraz zerową retencję w Enterprise Frontier Safeguards na infrastrukturze klienta.
Od czego polska firma może zacząć porównanie modeli?
Polska firma może zestawić tańszy Opus 5.5 z Fable 5.2 na tych samych polskich dokumentach. Pracownik ocenia poprawność odpowiedzi, czas potrzebny na poprawki oraz koszt wyniku, który zaakceptował.
W biurze rachunkowym zacznij od porównania danych z faktury i dokumentu opisującego zamówienie. W e-commerce użyj opisów produktów i zapytań klientów do przygotowania odpowiedzi. W obu przypadkach automatyzacja procesów biznesowych może przekazać dokument do modelu, a rezultat do zatwierdzenia pracownikowi.
- Zbierz polskie dokumenty z jednego procesu i przygotuj oczekiwane odpowiedzi do oceny.
- Uruchom te same zadania w Opus 5.5 oraz Fable 5.2, używając porównywalnych poleceń.
- Zapisz zużycie tokenów, czas oczekiwania i czas poprawek przy każdym wyniku.
- Skieruj proste sprawy do tańszego modelu, a trudniejsze przekaż Fable 5.2 do ponownej analizy.
- Zostaw pracownikowi zatwierdzenie wyniku i porównaj koszt zaakceptowanej odpowiedzi dla obu ścieżek.
W bardziej rozbudowanym procesie agent AI dla firmy może kierować sprawy między modelami. Podział nawiązuje do opisanej przez Anthropic roli Fable 5.2 jako doradcy lub modelu delegującego prostsze zadania.
Ile kosztuje Claude Fable 5.2 w porównaniu z konkurencją?
Fable 5.2 kosztuje standardowo 8 USD za milion tokenów wejścia i 40 USD za milion tokenów wyjścia. Token to fragment tekstu rozliczany przez API. Opus 5.5 ma stawki o połowę niższe, a GPT-6 Astra przy krótkim kontekście kosztuje odpowiednio 10 i 50 USD.
Ceny pochodzą z cennika Anthropic oraz cennika OpenAI. Kwoty dotyczą miliona tokenów i są podane w dolarach.
| Model i tryb | Wejście | Wyjście | Różnica względem standardu Fable 5.2 |
|---|---|---|---|
| Fable 5.2, standard | 8 USD | 40 USD | Punkt odniesienia |
| Fable 5.2, Fast | 16 USD | 80 USD | Wejście i wyjście o 100% droższe |
| Fable 5.1, standard | 10 USD | 50 USD | Wejście i wyjście o 25% droższe |
| Opus 5.5, standard | 4 USD | 20 USD | Wejście i wyjście o 50% tańsze |
| GPT-6 Astra, Standard, krótki kontekst | 10 USD | 50 USD | Wejście i wyjście o 25% droższe |
W porównaniu z Fable 5.1 stawki Fable 5.2 spadły o 20% zarówno dla wejścia, jak i wyjścia. Tryb Fast zwiększa szybkość generowania do 2,5 raza, a Fable 5.2 generuje odpowiedzi do 30% szybciej niż Fable 5.1. Fast nie łączy się z Batch.
Cache, czyli zapamiętana część zapytania, ma osobne stawki zapisu i odczytu. Batch ma osobny cennik. Tabela porównuje ceny Fable 5.2 i Fable 5.1 za milion tokenów.
| Pozycja w cenniku Anthropic | Fable 5.1 | Fable 5.2 | Zmiana w 5.2 |
|---|---|---|---|
| Zapis cache na 5 minut | 12,50 USD | 10 USD | −20% |
| Zapis cache na godzinę | 20 USD | 16 USD | −20% |
| Odczyt cache | 0,25 USD | 0,20 USD | −20% |
| Wejście Batch | 5 USD | 4 USD | −20% |
| Wyjście Batch | 25 USD | 20 USD | −20% |
Liczymy to tak: przy milionie tokenów wejścia i milionie tokenów wyjścia w standardowym API Fable 5.2 koszt wynosi 48 USD. Dla tej samej liczby tokenów Opus 5.5 kosztuje 24 USD, a GPT-6 Astra przy krótkim kontekście 60 USD. Porównujemy potem koszt zaakceptowanego wyniku, dodając koszt kolejnych prób i czas poprawek pracownika.
GPT-6 Astra ma dopłatę dla żądań przekraczających 272 tys. tokenów wejściowych: mnożnik wynosi 2 dla wejścia i cache oraz 1,5 dla wyjścia całego żądania. Cennik omawianych modeli Claude obejmuje kontekst do miliona tokenów bez dodatkowej stawki za długi kontekst.
Jak cena tokenu przekłada się na koszt zadania?
Wyższa stawka za token może iść w parze z niższym kosztem zadania. Anthropic porównał wyniki modeli przy różnych ustawieniach w FrontierCode 2.0.
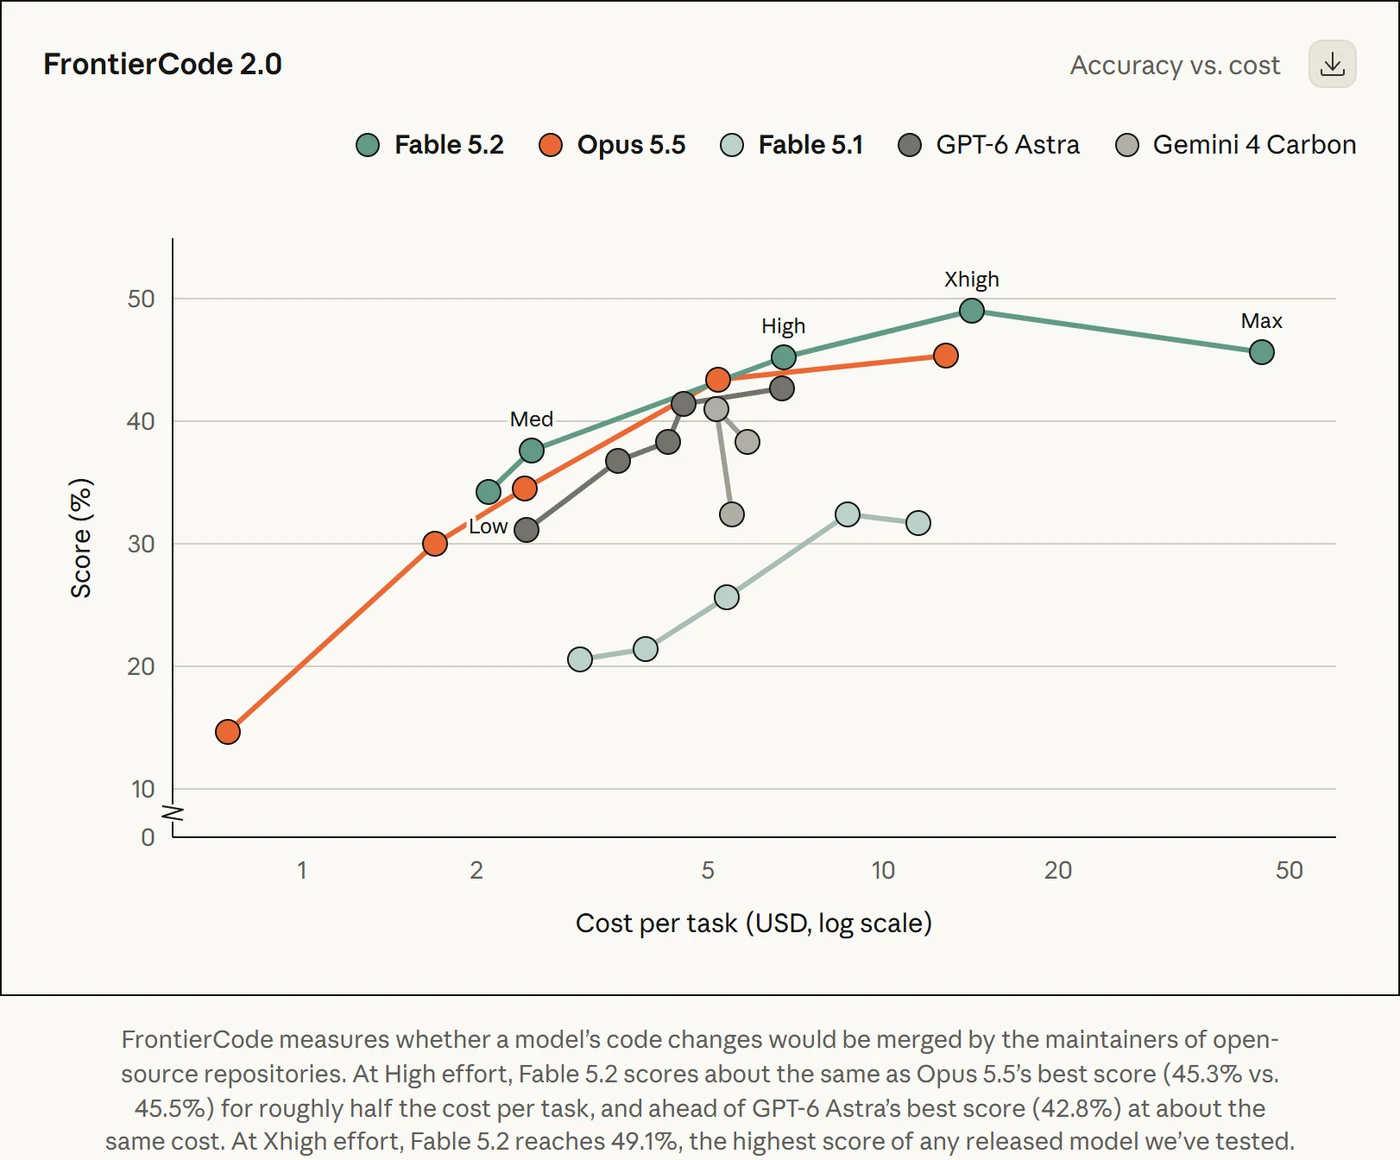 FrontierCode 2.0: wynik w zadaniach programistycznych względem kosztu jednego zadania (USD, skala logarytmiczna). Źródło: Anthropic, 2026.
Fable 5.2 na poziomie High osiągnął 45,3% w FrontierCode 2.0, wobec najlepszego wyniku Opus 5.5 wynoszącego 45,5%, za mniej więcej połowę kosztu zadania.
W WANDR Fable 5.2 na poziomie Medium dorównał najlepszemu wynikowi Opus 5.5 za około 40% kosztu. Anthropic porównał również koszty prób w Humanity’s Last Exam.
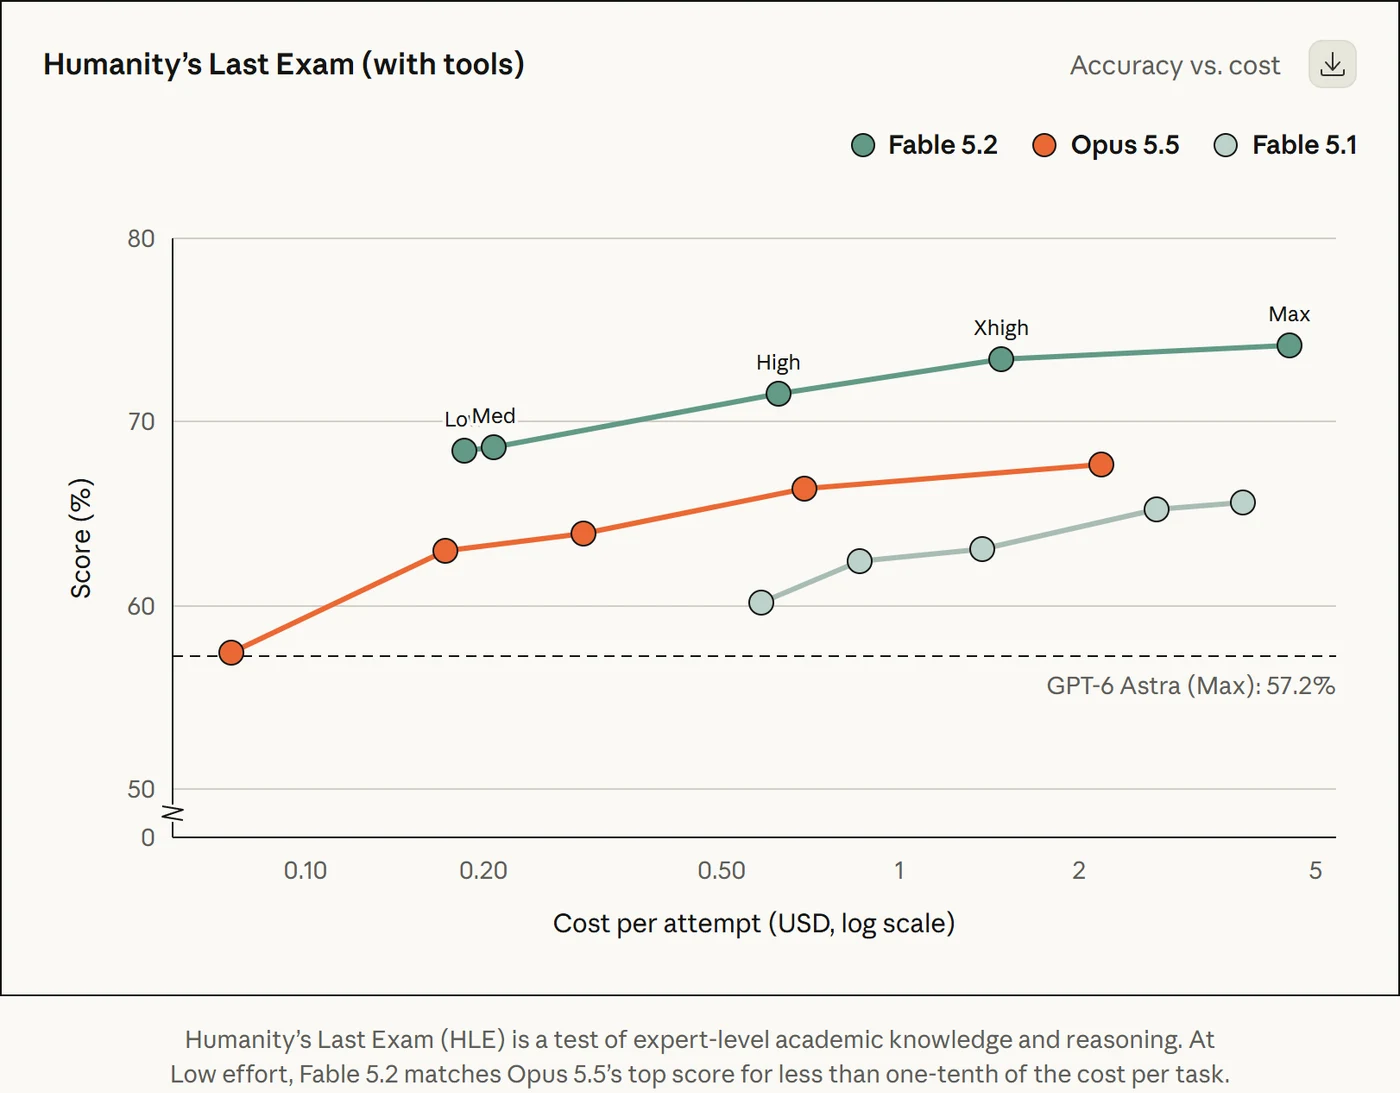 Humanity’s Last Exam (z narzędziami): wynik względem kosztu jednej próby. Linia przerywana to najlepszy wynik GPT-6 Astra. Źródło: Anthropic, 2026.
W Humanity’s Last Exam Fable 5.2 na poziomie Low dorównał najlepszemu wynikowi Opus 5.5 za mniej niż 10% jego kosztu w tym teście.
Najczęstsze pytania
Enterprise Frontier Safeguards pozwala monitorować bezpieczeństwo na infrastrukturze klienta przy zerowej retencji danych.
Jak uzyskać dostęp do Claude Mythos 5.2?
Organizacja musi uzyskać dostęp przez odpowiedni program weryfikacyjny Anthropic: Cyber Verification Program albo Life Sciences Verification Program. Claude Mythos 5.2 ma tę samą bazę co Fable 5.2, ale działa bez części blokad dotyczących cyberbezpieczeństwa i biologii. Standardowe stawki API obu modeli są identyczne.
Czy tryb Fast w Fable 5.2 jest droższy?
Tak, tryb Fast kosztuje 16 USD za milion tokenów wejścia i 80 USD za milion tokenów wyjścia. Stawki są dwa razy wyższe niż standardowe ceny Fable 5.2. Anthropic podaje, że Fast przyspiesza generowanie do 2,5 raza. Trybu Fast nie można połączyć z Batch.
Jak długo Anthropic przechowuje dane do monitoringu bezpieczeństwa?
30 dni wynosi opisana przez Anthropic retencja danych do monitoringu bezpieczeństwa dla pozostałych klientów. Enterprise Frontier Safeguards pozwala monitorować bezpieczeństwo na infrastrukturze klienta przy zerowej retencji danych. Przed wyborem integracji porównaj te warunki z wewnętrznymi zasadami przechowywania dokumentów obowiązującymi w Twojej firmie.
Czy Opus 5.5 jest tańszy od Fable 5.2?
Tak, standardowe stawki Opus 5.5 wynoszą 4 USD za milion tokenów wejścia i 20 USD za milion tokenów wyjścia. W obu pozycjach to połowa ceny Fable 5.2. Koszt ukończenia zadania zależy jednak od faktycznego zużycia tokenów i ustawień pracy modelu.
Podsumowanie
Fable 5.2 uzyskał wysokie wyniki w testach programistycznych, a Mythos 5.2 ma tę samą bazę przy ograniczonym dostępie i innych blokadach. Opus 5.5 kosztuje mniej za token, choć w wybranych testach Fable 5.2 osiągał porównywalny rezultat za ułamek kosztu zadania. W firmowym procesie dokumentowym porównaj oba modele na polskich materiałach i policz koszt zaakceptowanej odpowiedzi.